Ernesto Ibáñez
Las tres piezas de un asistente RAG
Cuando creo un asistente de este tipo tengo en cuenta tres cosas: el prompt de sistema (las instrucciones de base que le das al agente), el modelo de IA al que lo conectas y la base de datos donde guarda tu información. La que menos atención suele recibir es la base de datos, y para mí es la más importante.
Aquí uso Supabase, un servidor backend (la parte que guarda y sirve los datos de una aplicación) que funciona sobre PostgreSQL, una de las mejores bases de datos. Todo se monta con el plan gratuito de Supabase, que ya incluye PostgreSQL.
Cómo está montado el flujo en n8n
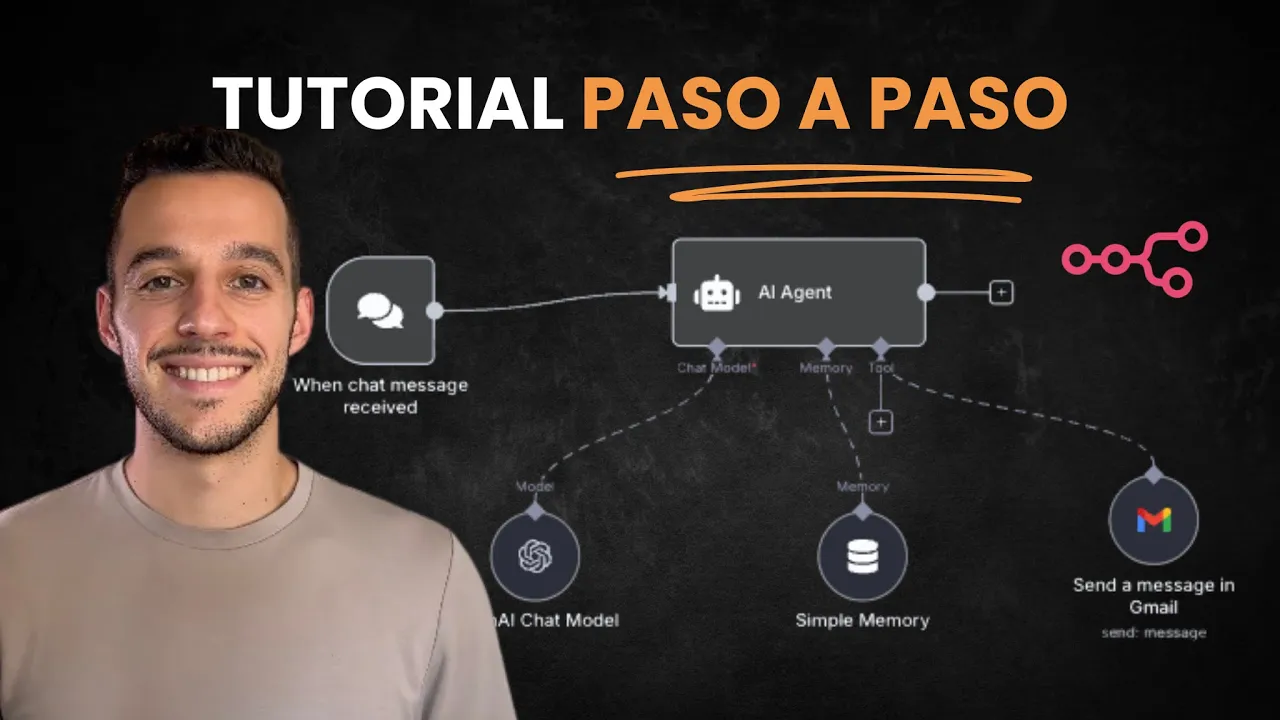
El flujo tiene dos partes. Arriba está la conversación: un nodo de chat y un nodo de webhook (una dirección a la que otra web puede mandar mensajes) conectados al agente, que usa un modelo de OpenAI, guarda la memoria en PostgreSQL, consulta Supabase como herramienta y contesta con Respond to Webhook. El asistente se puede insertar en cualquier web.
Abajo está la carga de documentos: subes los archivos a una carpeta de Google Drive y el flujo los mete en la base de datos de vectores de Supabase. Arranca con dos disparadores, uno cuando creas un archivo en la carpeta (File Created) y otro cuando lo modificas (File Updated).
El paso que suele faltar: borrar lo antiguo
La primera vez que creas la base de conocimiento, toda la información entra en Supabase. El problema llega cuando cambias un documento: si solo añades la versión nueva, la antigua se queda guardada, y lo que quitaste puede seguir apareciendo en las respuestas del asistente.
Por eso el flujo tiene un nodo, Delete Old Doc Rows, que antes de volver a cargar un archivo borra las filas que ese archivo tenía en la base de datos. Después lo descarga de Google Drive, saca el texto y lo inserta de nuevo.
El prompt de sistema y el modelo
El prompt de sistema se lo pedí a ChatGPT. Mi asistente iba a dar educación sanitaria a pacientes, así que le pedí esto:
Pedirle a ChatGPT el prompt de sistema
Quiero que crees un prompt de sistema para un agente de inteligencia artificial de n8n, el cual se va a encargar de proporcionar educación a mis pacientes.
Me devolvió rol, objetivos, limitaciones, personalización y estructura de respuesta. Quité el apartado de tono y algunas cosas más, y dejé la estructura de respuesta, porque en mi experiencia mejora mucho las respuestas de los agentes en n8n. Conviene que lo ajustes a tu caso.
Como modelo usé GPT-4o mini, que para una prueba consume poco.
Crear el proyecto en Supabase y conectarlo
- En Supabase, pulsa Start your project y luego Sign up now. Regístrate con email y contraseña o con GitHub y confirma el correo.
- Crea una organización (yo la dejé como Personal) con el plan de 0 dólares al mes.
- Crea el proyecto: nombre, contraseña de la base de datos (apúntala, la necesitarás después) y región. Yo elegí Irlanda, la más cercana.
- En n8n, crea la credencial de Supabase con el service role secret (en Project Settings → API Keys) y el host, que es la URL de Data API. Al probarla debe decir Connection tested successfully.
- En el nodo de Supabase del agente, elige el modo Retrieve Documents.
- Para crear la tabla, busca en la documentación del nodo Quickstart for setting up your vector store, copia el código SQL, pégalo en Supabase en SQL Editor y pulsa Run.
- En Table Editor aparecerá la tabla documents, con cuatro columnas; no hace falta tocarla. Elígela en n8n y deja la consulta match_documents.
La memoria de la conversación con PostgreSQL
- En el nodo de memoria de n8n, crea una credencial nueva de PostgreSQL.
- En Supabase pulsa Connect y usa los datos del apartado Transaction pooler. Con Direct connection no me funcionó.
- Copia el host, la base de datos (postgres), el usuario y el puerto, que es el 6543 y hay que cambiarlo en n8n. La contraseña es la de la base de datos que pusiste al crear el proyecto.
- Prueba la conexión y elige la opción Connected Chat Trigger Node.
- Como nombre de tabla deja n8n_chat_histories: con ese nombre se creará en Supabase la tabla del historial de conversaciones.
Para los embeddings (la conversión del texto en números que permite buscar por significado) elegí el modelo pequeño de OpenAI, text-embedding-3-small, y puse en cuatro el límite de resultados de la búsqueda. Y guarda el flujo a menudo, por si acaso.
Conectar Google Drive y preparar la carga de documentos
- Entra en Google Cloud Console con tu cuenta de Gmail (al registrarte con Comenzar gratis, cuando grabé el vídeo daban 300 dólares de crédito) y crea un proyecto nuevo.
- En APIs y servicios, busca Google Drive API y habilítala.
- En Pantalla de consentimiento de OAuth, pon el nombre de la aplicación y tu correo, elige usuarios externos y crea.
- Crea un cliente de OAuth de tipo aplicación web y, en URL de redireccionamiento autorizado, pega la URL que te da la credencial de Google Drive en n8n.
- Copia el ID de cliente y el secreto de cliente en n8n y guarda.
- Al iniciar sesión con Google me salió acceso bloqueado. Se arregla en Público → Publicar aplicación. Después, en el inicio de sesión, entra en la configuración avanzada y marca todos los permisos.
- Crea una carpeta en Google Drive y, en los dos disparadores de n8n, elige esa carpeta concreta y que la revisen cada minuto.
En el resto de nodos: Set File ID toma el identificador del archivo (`{{ $json.id }}`), el nodo que borra las filas antiguas filtra por ese file_id en los metadatos, y luego el archivo se descarga, se convierte si es un Google Docs, Slides, Sheets o una imagen, se extrae el texto y se inserta en documents. En el data loader añadí el file_id y dejé el tamaño de los trozos de texto en 1.000.
La prueba: preguntar, actualizar y volver a preguntar
Le pedí a ChatGPT un documento con información ficticia sobre la diabetes, lo dejé en la carpeta y ejecuté el disparador de archivo nuevo. Al preguntarle al asistente qué es la diabetes, contestó bien, pero sin consultar la base de conocimiento, porque el prompt no se lo pedía. Le añadí esto:
Línea añadida al prompt de sistema
Siempre consulta tu base de conocimiento. Si el usuario te pide algo que no está en la base de datos, quiero que le digas que no puedes responderle.
Con ese cambio, al preguntarle por los factores de riesgo de la diabetes tipo 2 ya buscó en Supabase y respondió con los del documento. En Supabase se veían dos tablas: documents, con el contenido vectorizado en cinco filas, y el historial de conversaciones, con cada sesión y sus mensajes.
Luego añadí al documento el número al que llamar para pedir cita (uno inventado), ejecuté el disparador de archivo actualizado y le pregunté por él: me dio el número nuevo. Todo el montaje me llevó menos de media hora.
Lo que hay que saber del plan gratuito de Supabase
En la cuenta gratuita de Supabase puedes tener como máximo dos proyectos, y si uno pasa una semana sin actividad (nadie habla con tu asistente) se desactiva solo. En el plan Pro, de 25 dólares al mes cuando grabé el vídeo, no pasa. Si lo mantienes activo, el gratuito funciona sin problema.
Preguntas frecuentes
¿Qué es un asistente RAG?
Es un agente de IA que, antes de responder, busca la información en tus propios documentos. Aquí los documentos están en Google Drive y se guardan vectorizados en Supabase.
¿Se puede hacer gratis?
La parte de Supabase y PostgreSQL, sí: todo se monta con el plan gratuito de Supabase, que ya incluye PostgreSQL. El modelo de OpenAI va por su API; para la prueba usé GPT-4o mini, que consume poco.
¿Por qué el asistente responde sin mirar mis documentos?
A mí me pasó porque el prompt de sistema no le decía que consultara la base de conocimiento. Al añadirle que la consulte siempre y que diga que no puede responder si algo no está ahí, empezó a buscar en Supabase.
¿Qué límites tiene el plan gratuito de Supabase?
Un máximo de dos proyectos, y un proyecto que pasa una semana sin actividad se desactiva automáticamente. En el plan Pro, que costaba 25 dólares al mes cuando grabé el vídeo, no ocurre.
Precios y condiciones a 21 de septiembre de 2025. Este texto acompaña al vídeo y resume lo que se ve en él.